
Si tienes prisa: cuando se me acaba la cuota de Claude, uso GPT-6 Luna por defecto (medio centavo por tarea), GPT-6.1 Sol para lo delicado y espero a Claude para los incidentes. Pero lo que vale la pena leer es por qué, y eso lo cuenta una sola tarea: arreglar un error de fechas. Diez de trece modelos la entregaron mal, y seis de ellos devolvían datos erróneos sin dar ningún error.
La cuota se acaba el jueves
Uso Claude Code a diario, y con un uso intensivo la cuota de la suscripción se acaba antes que la semana. Cuando pasa, quedan dos opciones: esperar a que se reinicie o seguir con otro modelo de pago por uso.
Le pregunté a otra IA qué modelo usar y la respuesta fue fácil: los modelos «Flash» más baratos, con una tabla de precios por millón de tokens. Suena razonable, pero ya había pasado por eso.
Hace unos meses probé MiniMax para lo mismo y no estuvo a la altura. Nada explotó: el problema era que el trabajo parecía terminado y no lo estaba. Ese es el fallo caro, porque te enteras tarde.
Así que esta vez lo medí antes de pagar. Trece modelos, ocho tareas sacadas de mi trabajo, tests que el modelo no veía y menos de diez dólares en total. El resultado cambió lo que tengo configurado, y no por la razón que esperaba.
Qué buscaba de verdad
Para un uso intensivo, una suscripción como las de Claude sale mucho más barata que pagar la API token a token, y ningún pago por uso se le acerca. Así que la pregunta no es «¿con qué sustituyo la suscripción?», sino «¿con qué cubro los días sin cuota, sin bajar la calidad?».
Y un consejo antes de cambiar de modelo: un agente de código relee el contexto entero de la sesión en cada turno, así que una sesión larga gasta la cuota mucho más rápido que varias cortas. La forma más barata de estirarla no es cambiar de modelo, es usar /clear entre tareas.
Cómo lo medí
Usé opencode, un agente de código de terminal parecido a Claude Code, pero de código abierto y que funciona con cualquier proveedor. Así los trece modelos alternativos trabajaban con las mismas herramientas y el mismo bucle; lo único que cambiaba era el modelo. Con Claude hice algo distinto, y lo explico más abajo. Los modelos venían de dos proveedores, OpenRouter y DeepInfra.
Las ocho tareas salen de lo que hago de verdad, con datos sintéticos:
| Tarea | Qué pide |
|---|---|
| t1 | Script de PowerShell que exporta los permisos de los buzones compartidos de Microsoft 365, con pruebas en Pester |
| t2 | Analizar un export del Unified Audit Log para encontrar reglas de buzón sospechosas (reenvíos externos, carpetas ocultas, palabras de pagos), típico de un BEC |
| t3 | Shortcode de newsletter para un plugin de WordPress, con nonce y escapado |
| t4 | Endpoint de Flask para relanzar un escaneo, siguiendo las convenciones del proyecto |
| t5 | Arreglar un error a partir de un traceback |
| t6 | Componente de Remotion en TypeScript estricto (un rótulo animado para vídeo) |
| t7 | Un escaneo masivo que a veces se cuelga para siempre, sin error ni log |
| t8 | Refactorizar un servicio para separar el motor de la API sin cambiar su comportamiento |
Las reglas del banco de pruebas:
- Tests ocultos. El modelo recibe el enunciado y el repositorio. Cuando termina, copio unos tests que nunca vio y los ejecuto. Antes los validé con una solución de referencia, para que fallar sea culpa del modelo y no del test.
- Una copia limpia por intento, con un commit de partida, para guardar exactamente lo que cambió cada modelo.
- Modo automático y 20 minutos de límite. Sin mi ayuda: si pregunta, nadie contesta.
- Revisión a ciegas de las tareas t4, t7 y t8: un revisor puntuó los diffs, barajados y sin nombre, sin saber de qué modelo era cada uno.
- El costo, comprobado contra la factura. En siete de los trece modelos, lo que calcula opencode coincide con lo facturado o se queda a dos centavos. En cuatro no: opencode usó precios de catálogo más altos de lo que de verdad cobraron DeepInfra y OpenRouter, hasta el doble en GLM-5.3 Flash. La tabla usa lo facturado.
Claude no corrió en opencode, y hay que decirlo. La referencia es Claude Opus 5.5 en Claude Code, con suscripción: cada tarea la hizo un subagente aislado, con el mismo enunciado, la misma copia del repositorio y los mismos tests ocultos, pero con las herramientas de Claude Code, no las de opencode. Para tener una comparación en igualdad de condiciones, pasé además Claude Opus 5.5 por la API dentro de opencode en cuatro tareas (t1, t4, t5 y t7): aprobó las cuatro, la t5 incluida, a unos 0,19 dólares por tarea.
Y el revisor a ciegas también era Claude. Un subagente de Claude Code con Opus 5.5, el mismo modelo que la referencia. No sabía de quién era cada diff, pero un modelo puede preferir el estilo que él mismo escribiría. Por eso las notas de la revisión las uso solo como apoyo; la conclusión sale de los tests.
Cada intento se lanzaba así:
opencode run --dir ./trabajo -m openrouter/openai/gpt-6-luna --auto --format json "$(cat prompt.md)"
--auto aprueba todo lo que no esté prohibido de forma explícita. Como no me gusta dejar a un modelo ejecutar comandos sin mirar, cada copia llevaba un opencode.json con lo que no podía hacer:
{
  "permission": {
    "edit": "allow",
    "webfetch": "deny",
    "external_directory": "deny",
    "bash": {
      "*": "allow",
      "git push*": "deny",
      "curl *": "deny",
      "Invoke-WebRequest*": "deny",
      "ssh *": "deny",
      "Remove-Item C:\\*": "deny"
    }
  }
}
Una advertencia, que este es un blog de seguridad: esto es un cinturón, no una jaula. Las reglas comparan texto, así que un python -c con urllib se salta el curl * sin problema. Para código que no conoces, usa una máquina virtual o un contenedor sin red.
Resultados
Así quedaron las ocho tareas, con Claude como referencia. El costo es lo que pagué por tarea de media, y la última columna es la tarea t5, que explico en la siguiente sección:
| Modelo | Tests | $/tarea | Mediana | t5 |
|---|---|---|---|---|
| Claude Opus 5.5 (Claude Code, referencia) | 8/8 | cuota | – | ✅ |
| Claude Opus 5.5 (API en opencode, control) | 4/4 | 0,19 | 90 s | ✅ |
| GPT-6 Luna | 8/8 y 7/8 (dos pasadas) | 0,005 | 103 s | ✅ las dos veces |
| GPT-6.1 Sol | 8/8 | 0,077 | 121 s | ✅ |
| GPT-6 Sol | 8/8 | 0,082 | 187 s | ✅ |
| Qwen3.8 Max | 7/8 | 0,099 | 282 s | ⚠️ detalle |
| Kimi K3 | 7/8 | 0,195 | 283 s | ⚠️ detalle |
| Grok Build | 7/8 | 0,070 | 258 s | ⚠️ detalle |
| DeepSeek V4 Pro | 7/8 | 0,044 | 221 s | ❌ fechas mal |
| DeepSeek V4.1 Flash | 7/8 y 7/8 (dos pasadas) | 0,004 | 63–82 s | ❌ fechas mal, las dos veces |
| Jev Router (TypeSafe en OpenRouter) | 7/8 | sin registro | 99 s | ❌ fechas mal |
| GLM-5.3 | 6/8 | 0,09 | 146 s | ⚠️ detalle |
| GLM-5.3 Flash | 6/8 | 0,004 | 341 s | ❌ fechas mal |
| MiniMax M2.7 | 5/8 | 0,055 | 120 s | ❌ fechas mal |
| MiniMax M3 | 3/8 | 0,019 | 741 s | ❌ fechas mal |
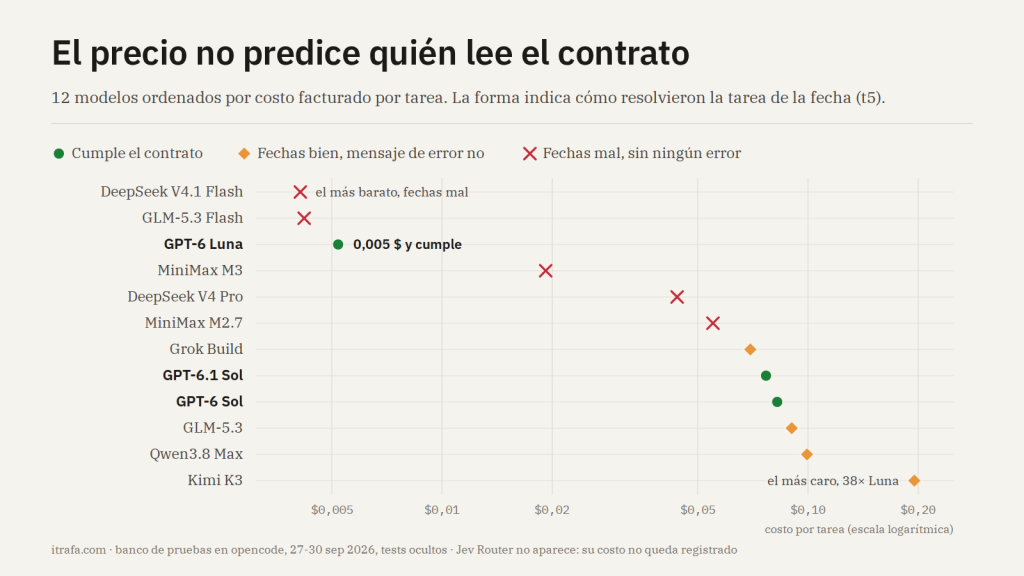
Mirando solo la columna de tests parece que casi todos aprueban: 7 de 8 por aquí, 7 de 8 por allá. El 7/8 de casi todos ellos lo explica la misma tarea, la t5.
La excepción es el 7/8 de Luna en su segunda pasada, y como es mi modelo por defecto, lo explico. Falló la t6, el rótulo animado: el enunciado pedía que la opacidad bajara de 1 a 0 durante los últimos 15 fotogramas, y Luna hizo que llegara a 0 ya en el último fotograma visible, así que el rótulo desaparece un fotograma antes de lo que esperaba el test. En un vídeo a 30 fotogramas por segundo es una trigésima de segundo, y el enunciado admite las dos lecturas. Pero el test lo marca, y lo cuento como fallo.
La tarea que lo decidió todo: una fecha
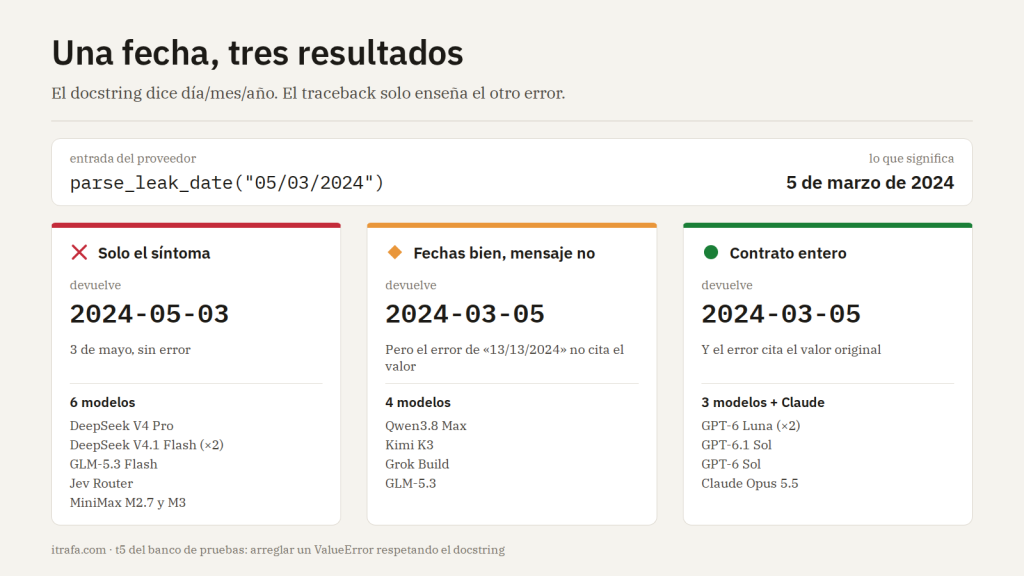
La t5 es corta. Un script normaliza las brechas de datos que devuelven distintos proveedores de inteligencia de amenazas, y al importar los de un proveedor nuevo salta este error:
breaches.py:33: in parse_leak_date
    return date.fromisoformat(s)
E   ValueError: Invalid isoformat string: '2024-03'
El enunciado era el traceback y una frase: «La función tiene que cumplir lo que dice su docstring». Y el docstring dice esto:
def parse_leak_date(value: str | None) -> date | None:
    """Convierte la fecha de una brecha a `date`.

    Formatos que envían los proveedores:
      - ISO completo:      "2024-03-15"            -> 2024-03-15
      - Solo año-mes:      "2024-03"               -> 2024-03-01
      - Europeo:           "15/03/2024"            -> 2024-03-15   (día/mes/año)
      - Mes en inglés:     "March 2024"            -> 2024-03-01
      ...
    Cualquier otro valor lanza ValueError con el valor original en el mensaje.
    """
El error del traceback es fácil: la rama que trata las fechas con guion se come 2024-03 antes de que llegue a la rama de año-mes. Pero hay un segundo error que el traceback no enseña. Lo ve quien lee el contrato y lo compara con el código:
    if "/" in s:
        month, day, year = (int(p) for p in s.split("/"))   # mes/día: formato de EE. UU.
        return date(year, month, day)
El docstring dice día/mes/año y el código lee mes/día/año. Ningún test existente lo cubre.
Los modelos se repartieron en tres grupos.
Los que solo arreglaron el síntoma. DeepSeek V4 Pro, DeepSeek V4.1 Flash, GLM-5.3 Flash, el Jev Router y los dos MiniMax hicieron prácticamente lo mismo: mover dos líneas.
     if "T" in s:
         return datetime.fromisoformat(s.replace("Z", "+00:00")).date()

+    if len(s) == 7 and s[4] == "-":
+        return date(int(s[:4]), int(s[5:]), 1)
+
     if "-" in s:
         return date.fromisoformat(s)
El traceback desaparece y los tests del repositorio pasan. Es un arreglo que cualquiera aprobaría en una revisión rápida. Pero 05/03/2024, el 5 de marzo, ahora sale como 3 de mayo, sin ningún error. Con 15/03/2024 al menos explota, porque no hay mes 15. Con cualquier día del 1 al 12 obtienes una fecha válida y equivocada.
Piensa dónde acaba eso: un informe de brechas con las fechas cambiadas, una línea de tiempo de un incidente desordenada, un filtro de «últimos 30 días» que deja fuera lo que no debería. Nadie se entera hasta que alguien compara con el original.
DeepSeek V4.1 Flash lo repitió igual en la segunda pasada. No fue mala suerte: es como se comporta ante este tipo de tarea.
Los que arreglaron las fechas pero no el mensaje. Qwen3.8 Max, Kimi K3, Grok Build y GLM-5.3 leyeron el docstring y arreglaron el formato europeo. Fallaron en la última línea: ante un valor inválido como 13/13/2024, el error decía month must be in 1..12, not 13 en lugar de incluir el valor original. Es un detalle, y se lo marco como detalle. Pero también estaba escrito en el contrato.
Los que cumplieron el contrato entero. Claude, GPT-6 Sol, GPT-6.1 Sol y GPT-6 Luna. Luna, además, en las dos pasadas. Su arreglo comprueba cada formato con una expresión regular exacta en vez de buscar un carácter suelto, lee día/mes/año y convierte cualquier fallo en el ValueError con el valor original.
Lo que más me sorprendió es que el precio no predijo nada. Kimi K3 fue el más caro de la prueba, a 0,20 dólares por tarea, y se dejó el detalle del mensaje. GPT-6 Luna costó 0,005 dólares, casi cuarenta veces menos, y cumplió todo. La tabla de precios que me dio la otra IA ordenaba los modelos por lo único que no importaba.
Lo que los tests no ven
Los tests ocultos atrapan mucho, pero no todo. Por eso hubo revisión a ciegas.
La condición de carrera de t4. El endpoint tenía que devolver 409 si ya había un escaneo en curso. Casi todos lo hicieron así: leer el estado, comprobarlo y escribirlo. Si llegan dos peticiones a la vez, las dos leen «libre» y se lanzan dos escaneos. Ni el enunciado ni los tests lo mencionaban. Solo Claude y los dos GPT Sol protegieron la comprobación y el cambio de estado con un candado, para que no pudieran ocurrir a la vez. GPT-6.1 Sol añadió incluso un test que lanza dos peticiones en paralelo. Luna, no. Es la razón por la que no le dejo a Luna nada con concurrencia.
Más no es mejor. En t7, el escaneo que se colgaba, los seis de la revisión a ciegas encontraron la causa: el hilo solo capturaba los errores de DNS, cualquier otro error lo mataba y la cola esperaba para siempre. Claude lo arregló convirtiendo un módulo de 43 líneas en uno de 128, con su propio bucle de sondeo y tiempos de espera por dominio. El revisor ciego lo llamó «desproporcionado» y le dio un 1 sobre 5 en fidelidad al encargo. GPT-6 Sol lo resolvió con un cambio de unas 40 líneas, tests incluidos, y sacó la nota máxima. Luna, que llegó después de la revisión a ciegas, también dio con la solución completa en su primera pasada; esto lo comprobé yo leyendo su diff: capturar cualquier excepción, garantizar con un finally que cada dominio acaba en resultados o en errores, y validar el número de hilos.
Las notas globales de la revisión a ciegas de la primera ronda, sobre 5:
| Modelo | t4 | t7 | t8 |
|---|---|---|---|
| GPT-6 Sol | 5 | 5 | 4 |
| Qwen3.8 Max | 3 | 4 | 5 |
| Kimi K3 | 3 | 4 | 4 |
| Grok Build | 3 | 3 | 3 |
| DeepSeek V4 Pro | 2 | 2 | 3 |
| Claude Opus 5.5 | 2* | 2* | 3* |
*Las tres soluciones de Claude borraban el opencode.json y añadían una copia de los tests ocultos. Ninguna de las dos cosas era del modelo: Claude corrió en Claude Code, donde ese archivo no se usa, y la copia de los tests la dejó mi proceso de corrección. El revisor no podía saberlo y las penalizó, con razón: tal cual, no se podían fusionar. Mirando solo la corrección del código, le dio 5, 4 y 5.
Rarezas que conviene saber
GLM-5.3 pensó 32 000 tokens y no escribió nada. En la primera tarea razonó hasta el límite de salida, no creó ningún archivo y costó 0,08 dólares. Lo repetí con otra configuración de razonamiento y pasó exactamente lo mismo. Si un modelo puede gastarse el presupuesto entero pensando, conviene saberlo antes de dejarlo solo.
MiniMax quedó último, y eso valida la prueba. MiniMax M3 aprobó 3 de 8 y agotó los 20 minutos en varias tareas; M2.7 aprobó 5 de 8. Es justo lo que viví usándolo. Si mi banco de pruebas hubiera puntuado bien al modelo que en la práctica me falló, el que estaría mal sería el banco. Que lo reprodujera me dio confianza en el resto de resultados.
El enrutador no dice qué hizo. El Jev Router, el enrutador de TypeSafe en OpenRouter, elige un modelo para cada petición. Falló la t5 como los modelos baratos, y en el registro de opencode no aparece qué modelo eligió ni cuánto costó: marca 0 dólares en las ocho tareas. Así no sabes quién hizo cada cosa ni lo que pagas por tarea. Enrutar me sigue pareciendo buena idea, pero con mis criterios y entre modelos que ya medí, no a ciegas.
Lo que uso ahora
Una escalera de tres escalones:
| Escalón | Modelo | Para qué | $/tarea |
|---|---|---|---|
| 1 (por defecto) | GPT-6 Luna | Casi todo: scripts, componentes, plugins, refactors con tests | ~0,005 |
| 2 (preciso) | GPT-6.1 Sol, con GPT-6 Sol de reserva | Bugs, lógica de negocio, parseo de datos, concurrencia, código sin tests | ~0,08 |
| 3 | Esperar a Claude | Incidentes en tenants, producción, arquitectura, seguridad | cuota |
Para saber en qué escalón va una tarea me hago una sola pregunta: ¿puedo comprobar objetivamente que quedó bien? Si hay tests o una verificación clara, escalón 1. Si no, escalón 2 como mínimo. Y para un incidente real no me fío de dos tareas complejas aprobadas: ahí espero a Claude o lo pago por API.
En opencode lo tengo como dos agentes, y se cambia de uno a otro con Tab. Este es el archivo, en ~/.config/opencode/opencode.jsonc, sin claves: las lee de la variable de entorno OPENROUTER_API_KEY.
{
  "$schema": "https://opencode.ai/config.json",
  "enabled_providers": ["openrouter"],
  "provider": {
    "openrouter": {
      "whitelist": ["openai/gpt-6-luna", "openai/gpt-6.1-sol", "openai/gpt-6-sol"],
      "models": {
        // GPT-6.1 Sol es muy nuevo y puede no estar aún en el catálogo de opencode
        "openai/gpt-6.1-sol": {
          "name": "GPT-6.1 Sol",
          "tool_call": true,
          "reasoning": true,
          "cost": { "input": 2, "output": 10, "cache_read": 0.1 },
          "limit": { "context": 1050000, "output": 128000 }
        }
      }
    }
  },
  "model": "openrouter/openai/gpt-6-luna",
  "small_model": "openrouter/openai/gpt-6-luna",
  "agent": {
    "build":   { "model": "openrouter/openai/gpt-6-luna" },
    "plan":    { "model": "openrouter/openai/gpt-6.1-sol" },
    "preciso": {
      "mode": "primary",
      "model": "openrouter/openai/gpt-6.1-sol",
      "description": "Bugs, lógica de negocio, parseo de datos, concurrencia y código sin tests."
    }
  }
}
Si usas OpenRouter, ponle un límite de gasto a la clave. Es una casilla en el panel, y un agente en modo automático con un bucle mal parado puede gastar mucho.
Dos detalles de precio
Para el uso diario, una suscripción sigue siendo lo más barato. Lo que cambia es que cubrir los días sin cuota con Luna cuesta centavos por tarea. Dos detalles de la página de precios de OpenAI que conviene conocer antes de usar estos modelos en sesiones largas:
- El recargo por contexto largo. Con prompts largos (a partir de unos 272 000 tokens, según OpenRouter), la entrada cuesta el doble y la salida 1,5 veces más. En una sesión larga de un agente es fácil pasar de ahí. La solución es la misma de antes: una sesión nueva por tarea (
/newen opencode). - El nivel Flex, a mitad de precio a cambio de esperas. Está en la API directa de OpenAI y también en OpenRouter, que lo ofrece como un proveedor más (
openai/flex) de GPT-6 Luna y GPT-6.1 Sol. No lo he probado con opencode, y el día que lo miré el Flex de GPT-6.1 Sol estaba degradado, con un 89 % de disponibilidad en la última media hora.
Haz tu propia prueba en una tarde
Mis resultados sirven para mis tareas. Si tu trabajo es otro, la prueba se monta rápido:
- Elige 5 a 8 tareas reales de las que haces cada semana, con datos inventados. Que cubran tus lenguajes y al menos una sea difícil.
- Escribe los tests antes y escóndelos. Valídalos con tu propia solución. El modelo no los ve hasta que termina.
- Incluye una tarea de contrato: un error con traceback en el que el arreglo obvio deja otro fallo que solo se ve leyendo la documentación. Es la que más separa a unos modelos de otros, y te dice si el modelo lee o solo reacciona.
- Una copia limpia y un modo automático por intento, con límite de tiempo y comandos peligrosos prohibidos.
- Repite al menos una vez con los modelos que te interesan. Una sola pasada no distingue la suerte de la costumbre.
- Compara el costo con la factura real, no con lo que dice la herramienta. A mí opencode me calculó de más en cuatro modelos, en GLM-5.3 Flash el doble de lo facturado, porque usaba un precio de catálogo y no el del proveedor que de verdad atendía.
- Incluye un modelo que ya conoces de la práctica. Si tu prueba no reproduce lo que viviste con él, la prueba está mal.
Lo que no medí
- Ocho tareas, una o dos pasadas. Es una señal fuerte, no una garantía.
- Tareas cortas. Las sesiones reales de trabajo son mucho más largas, con otra mezcla de caché y contexto, y el costo por tarea puede cambiar.
- La t5 la diseñé yo, y una sola tarea pesa mucho en la conclusión. Que se repitiera igual en dos pasadas le da peso, pero sigue siendo una tarea.
- Solo con opencode. Con otro agente, con otras herramientas e instrucciones, los resultados pueden cambiar. La referencia de Claude corrió en Claude Code, no en opencode; el control por API en opencode fueron solo cuatro tareas.
- Un juez de la casa. El revisor a ciegas fue Claude Opus 5.5, el mismo modelo que la referencia. No sabía de quién era cada diff, pero no es un juez neutral.
- Modelos y precios del 27 al 30 de septiembre de 2026. Cambian cada pocas semanas. Pienso repetirlo cada tres meses.
Fuentes
- OpenAI: precios de la API, consultados el 30 de septiembre de 2026.
- opencode: documentación y permisos.
- OpenRouter y DeepInfra: precios de cada modelo en sus catálogos, del 27 al 30 de septiembre de 2026, y sus facturas de uso de septiembre.
- MiniMax: precios del Token Plan.
Seguir leyendo en IT Rafa
- Jev elige el modelo de Claude Code: lo medí antes de recomendarlo, la otra mitad de esta historia: elegir modelo dentro de Claude.
- Código generado por IA: el costo real en seguridad.
- Reconstruí mi blog con una IA: esto es lo que se rompió.